机器学习势分子动力学模拟笔记
这是一篇 J. Chem. Phys. 上的计算文章,引用量比较高,研究的是固态电解质里的离子扩散。要说明它为什么值得读,得先看扩散系数有多难算。
最直接的办法是 AIMD,物理上干净,几乎不依赖经验拟合,但它太贵:几十皮秒的时间尺度、几百个原子的体系,基本就是它的上限。而要拿到精确的扩散系数,得在纳秒尺度上看离子跑动,室温下更不必想。所以常见的做法是绕一下路:先在高温(600–1200 K)下跑 100–400 ps,假设一条单一的阿伦尼乌斯关系贯穿整个温度区间,再从高温一路外推到工作条件(–40 °C 到 80 °C)下的离子电导率。假设阿伦尼乌斯关系处处成立,等于假设扩散机制不随温度改变。这样做有两个隐患:只要阿伦尼乌斯关系在某个温度区间失效,整个预测就失去了立足点;而且 AIMD 在室温下应用于固态电解质材料时,往往会显著高估扩散系数,并不是"算慢了这么一点"的问题。
更彻底的出路是直接在室温下模拟扩散本身。这需要更大的体系和更长的轨迹来保证收敛,也就需要用机器学习势来描述势能面对原子坐标的多体、非线性依赖。但训练数据从哪来?最直接的来源还是 AIMD。原文在这里引了一句话,说得比转述更清楚:
However, this procedure is computationally demanding, and the generated snapshots are highly correlated, reducing the quality of the training data
AIMD 轨迹里相邻的快照高度相关,真正独立的信息并不多。因此大多数基于机器学习的模型开发都夹杂着大量试错,可靠性也因此受到质疑。作者的回应是把试错变成可量化的自动迭代,这就是 DP-GEN 并发学习框架。
下面是跟着这篇文章复现的记录。严格说,这是一次没有完成的复现:原文给出的细节有限,不少生成参数只能靠猜;训练推进到第二阶段(超胞模型)时显存不足,16 GB 的卡撑不住,只好停在那里。不过停下的只是训练这一条线。跑模拟的间隙里,我补了不少后处理、统计和可视化方面的课,笔记记了一路,就是文章的后半部分。前一半是照着别人的文章走,后一半更像是自己摸索出来的学习记录。复现算不上成功,这些笔记多少还是有些用处的。
¶DP-GEN 并发学习——失败😢
作者用的框架是 DP-GEN,深势科技参与开发,应该和 DeepMD 项目有些渊源。
它的迭代逻辑不复杂,三步反复:用高精度单点 DFT 给构型"打标签";用整个数据集同时训练一组四个结构相同(相同网络层数和节点数)、随机种子不同的 DP 模型;让这四个刚训练好的模型去跑 MD,跑的过程中实时计算每个时刻构型的
它被用来回答一个很朴素的问题:当前这个构型,对模型来说是"已知领域"还是"未知领域"。筛选机制分三档:
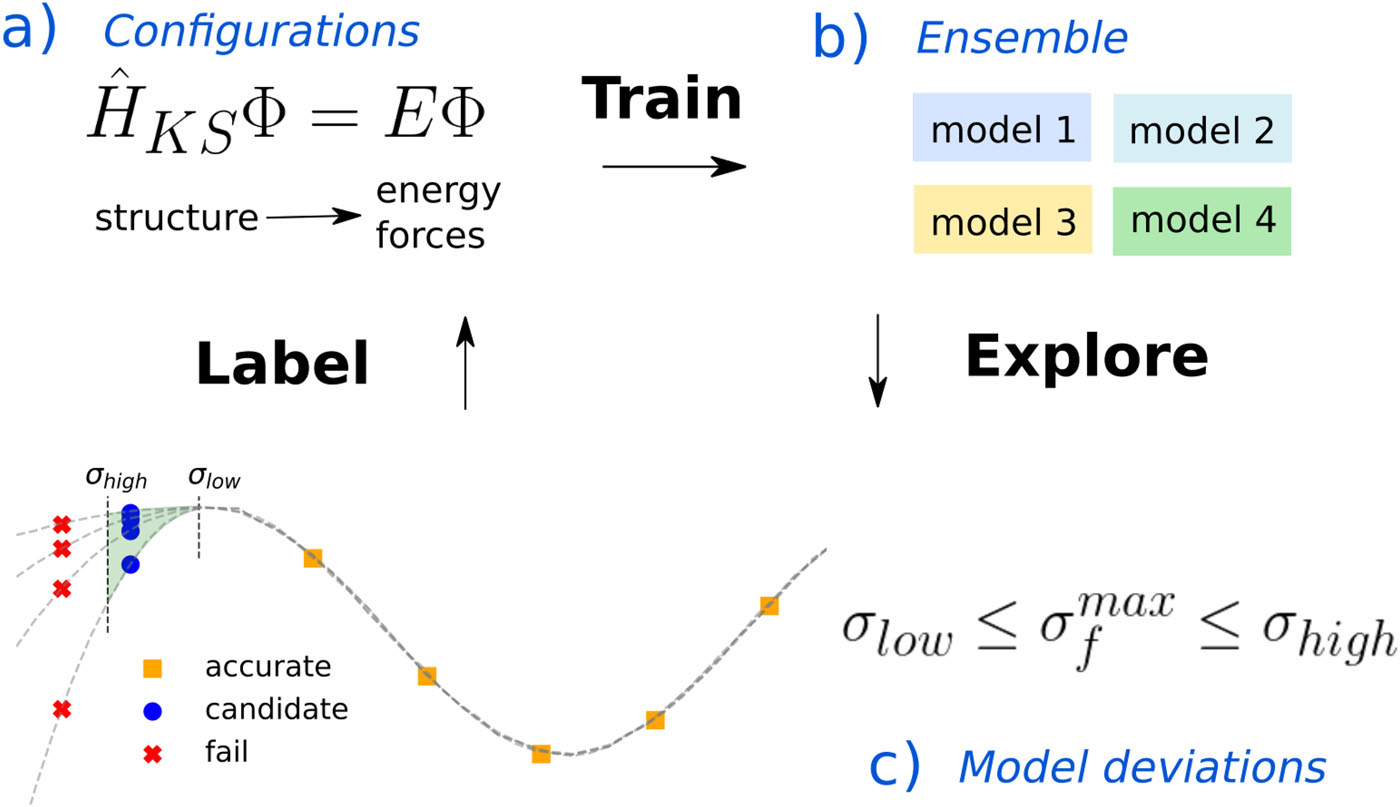
启动迭代需要一个初始数据集:从 DFT 弛豫后的结构出发,通过微扰生成几百个初始构型。LGPS 的原始结构从 Materials Project 获取(ID: mp-696138),用 VASP 6.6.0 做变胞优化,优化后晶胞参数为:
1 | a = 8.64965 Å α = 91.3519° |
安装 DP-GEN 只有一行:
1 | uv pip install dpgen |
原文并没有给出生成这 590 个构型所用的具体参数,比如体积缩放列表 scale、每个体积生成几个 pert_numb、晶胞扰动幅度 pert_box、原子扰动幅度 pert_atom、随机种子,以及是否经过短程 AIMD 后抽帧。只好自己猜一套,写成 init_590.json:
1 | { |
也就是说:五档晶格缩放(0.98–1.02),每档随机生成 118 个扰动结构,5 × 118 = 590。再添一个占位文件 incar.scaffold:
1 | SYSTEM = LGPS scaffold only |
运行分两个 stage:stage 1 放置元素,stage 2 扰动和缩放。
1 | (storm) [storm@vasp-v100 02_init_590]$ dpgen init_bulk init_590.json |
Stage 1 跑完可以检查一下:
1 | find POSCAR_relaxed.01x01x01/00.place_ele \ |
其中必须存在:
1 | POSCAR_relaxed.01x01x01/00.place_ele/sys-0004-0024-0002-0020/POSCAR |
然后把 JSON 改成 stage 2:
1 | python - <<'PY' |
再次运行,输出和第一次几乎一样,关键的一行换成了 Current stage is 2, perturb and scale。跑完数一数扰动构型的数目:
1 | (storm) [storm@vasp-v100 02_init_590]$ find POSCAR_relaxed.01x01x01/01.scale_pert \ |
每个 scale 目录的结构是:
1 | scale-0.990/ |
所以根 POSCAR 和 000000 是同一个未扰动参考(dpgen 写了两份),000001–000118 才是 118 个真扰动结构;5 档 × 118 = 590,正好等于 coll_ndata,未扰动的参考不计入 590。
DFT 单点算完之后,用 collect_labels.py 脚本把 OUTCAR 合并输出为 deepmd/npy 数据格式,然后启动 DP-GEN 迭代循环。一共跑了四轮,准确率到 99.65%,程序自动停止。但停下的只是第一阶段,固定有序占位的 1×1×1 小体系;原文接下来分四个后续阶段逐步扩大探索范围,每个阶段都在上一阶段训练好的模型基础上探索新的构型空间,收敛后再进下一个。
然后在训练第二阶段(超胞模型)的时候,炸显存了。16 GB 显存还是太小,这条线暂时搁在这里。
¶后处理与输运分析
复现停在了第二阶段,但笔记一直在记。这一部分是复现过程中学到的另一批东西:手里有一条 ML-MD 轨迹之后,怎么把它变成一个可信的扩散系数。
这部分原本是边跑模拟、边查文献、边学 VMD/OVITO、边补统计学知识时记下来的零散笔记,顺序非常跳跃:刚讲完 VMD 就跳到 Nernst–Einstein,刚讲完热浴又跳到 bootstrap,MSD、Green–Kubo、重复模拟、kinisi 全搅在一起。整理时按一条主线排过:
先搞清楚 MD 里在算什么 → 把轨迹看明白 → 从轨迹算 MSD 和扩散系数 → 讨论拟合区间、采样与不确定度 → 最后才谈离子电导率。
即使现在,对 kinisi 和不确定度部分的认识仍有局限,还需要慢慢琢磨😂。下面的行文尽量把"当时为什么困惑"和"后来怎么想明白"都留下来,不一定完全正确,欢迎交流。
先从最基本的量说起。MD 里经常看到势能、动能和总能量:
温度本质上和平均动能有关。例如在 NVE 系综中,势能和动能可以不断互相转换,但理想情况下总能量应近似守恒。不过,真正直接推动原子运动的不是"总能量"这个数,而是力。力是势能对原子位置的负梯度,积分器再根据牛顿第二定律更新速度和位置。可以很粗略地记成:能量告诉我势能面"有多高",力告诉原子"往哪里走、加速多快",应力告诉晶胞"受到多大的推、拉和剪切"。
训练机器学习势时,力尤其重要。一个结构只有一个总能量标签,却有
三个最常见的系综需要分清。NVE 是微正则系综,体系不与外界交换能量,没有 thermostat(热浴/恒温器)和 barostat(压浴/恒压器),总能应近似守恒。它适合检查时间步长是否合理,检查积分或模型有没有严重能量漂移,尽量减少 thermostat 对真实动力学的干扰,以及做速度自相关、振动等动力学分析。NVT 是正则系综,体积固定,体系可以和 thermostat 交换能量,在目标温度附近采样,适合固定晶格参数下的离子扩散、结构和热力学性质,也常被直接用于固态电解质的生产 MD。LGPS 相关的 AIMD 模拟里,NVT 用得比较多。NPT 同时控制温度和压力,晶胞可以膨胀、收缩甚至改变形状,适合得到目标温度和压力下更合理的体积、密度和热膨胀行为。不过对输运性质要小心:barostat 会直接改变晶胞和原子坐标,不能不加判断地把 NPT 轨迹直接拿来算动力学量。
一个常见的流程是:
1 | 结构优化 |
这不是唯一流程,许多 MD 教材(尤其是生物大分子方向)都会提到它。真正重要的是平衡阶段和生产阶段要分开,生产轨迹采用什么系综,要结合具体研究对象和 thermostat sensitivity 来验证。时间步长也没有放之四海而皆准的固定值,只有一些经验范围:含氢体系常见约 0.5–1 fs,无氢无机固体常见约 1–2 fs,AIMD 常见约 0.5–1 fs;高温、强碰撞或模型稳定性未知时,更倾向于小步长。
系综和步长定了之后,在真正算扩散系数之前,我很喜欢先把轨迹"看一遍"。这一步代替不了定量分析,但很多低级错误,比如 PBC 设错了、模拟跑飞了、结构崩了、扩散通道不对劲,眼睛一扫就能发现,比任何统计量都来得直接。
载入轨迹(UMA-MD,使用 uma-s-1p2p1.pt 模型权重,400000 步,每步 1 fs,VMD 中的载入类型应当是 VASP_XDATCAR5)后先读晶胞:
1 | package require pbctools |
读到的一组晶胞参数是:
1 | {17.179901 17.759081 25.949924 91.984161 90.642601 90.249100} |
画出周期性盒子:
1 | pbc box -on -center unitcell -color black -width 2 |
如果只是想做一个正常的"晶胞内动画"(载入 mlipx 输出的 XDATCAR 是 unwrap 的),可以把原子重新 wrap 回主晶胞:
1 | pbc wrap -all -sel "all" -center unitcell |
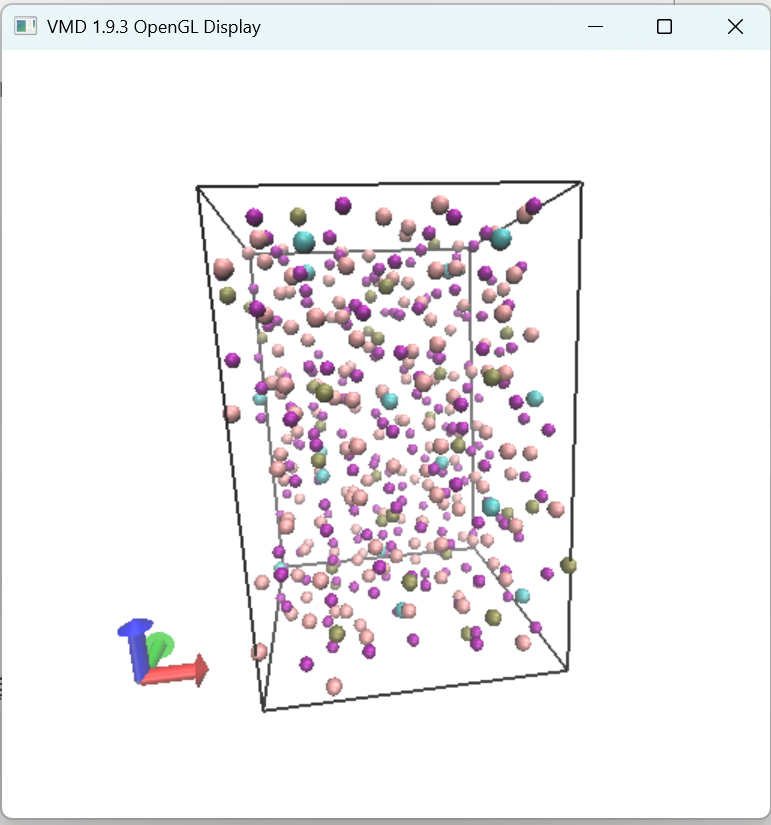
不过这里有个容易踩的坑。PBCTools 的 wrap 只是把周期镜像中的原子重新塞回主晶胞,图看着舒服了而已。用于 MSD 的坐标处理完全是另一回事:需要 unwrap,让扩散轨迹在空间上连续,否则原子每次"穿越"盒子边界跳回对面,算出来的位移就全乱了。如果载入的轨迹本身已经是 unwrap 的(比如 mlipx 输出的 XDATCAR),直接用就行;如果是 wrapped 坐标,先跑一遍 pbc unwrap -all。
接下来是美化。Li 用 VDW 突出球体,Ge/P/S 用 Licorice 展示骨架连接,颜色按元素,白色背景,正交投影,关掉坐标轴,这样截图比较干净:
1 | color Display Background white |
要看 Li 在整段模拟里主要经过哪些区域,可以用 VolMap(Extensions → Analysis → VolMap Tool),选 element Li,Map type 用 Occupancy,对所有帧计算后取 Average,Resolution 从 0.3–0.5 Å 起步,越小分辨率越高但越慢。VMD 会把空间划成许多 voxel,对每一帧判断 Li 是否占据该位置,再对时间取平均,所以得到的是一种 Li 的时间平均空间占据分布。计算完成后用 Isosurface 表示,同时画两个不同 isovalue,低的做半透明、高的做实心,对比很直观:
1 | set molid top |
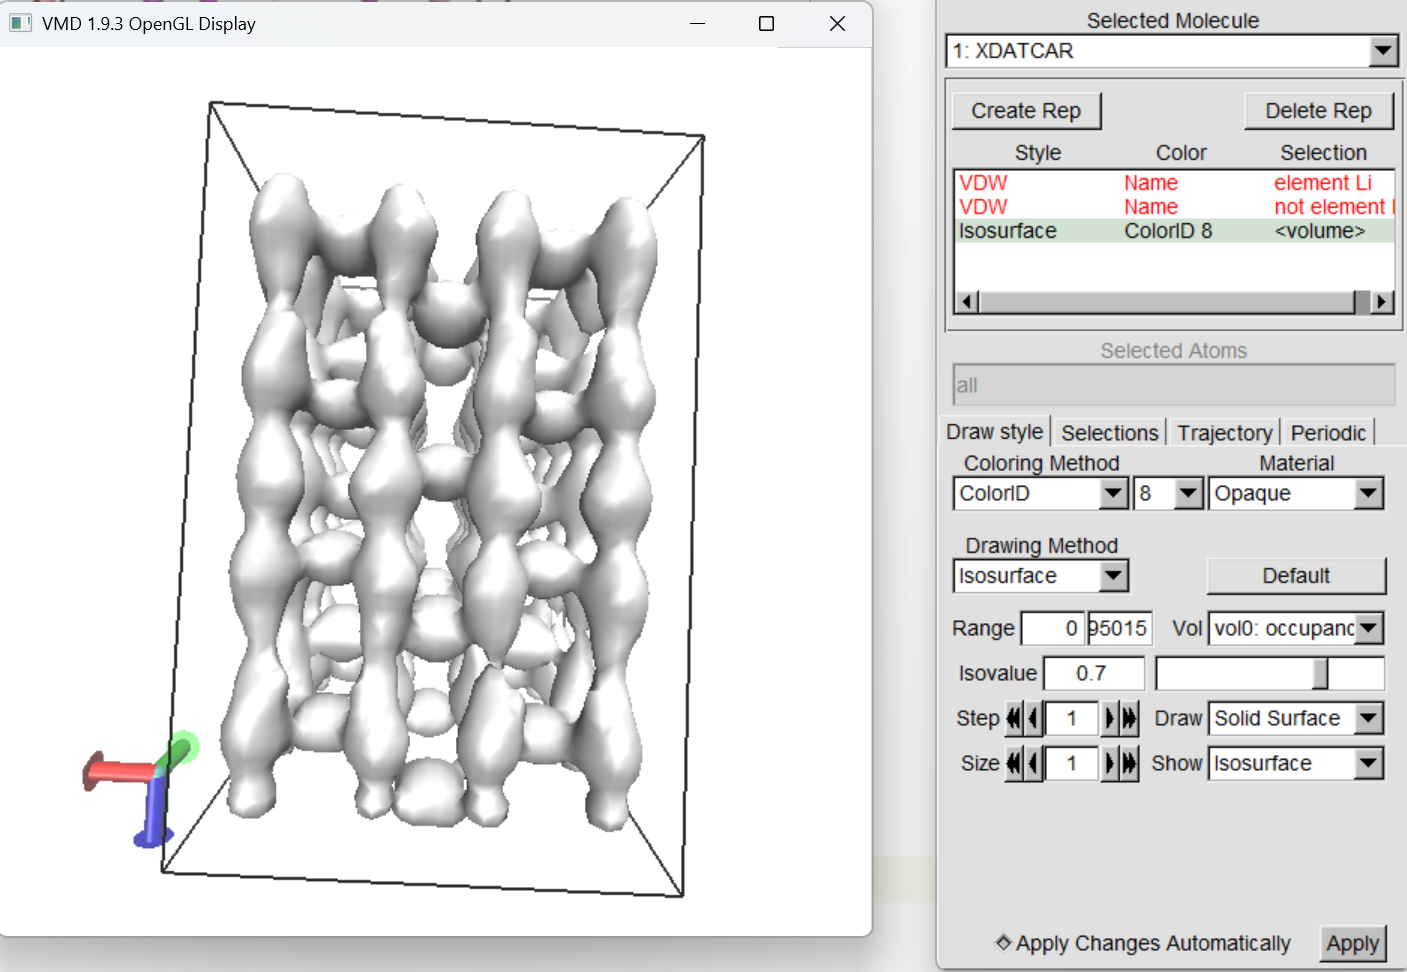
VolMap 很直观,但要记住它回答的是"Li 经常出现在哪里",而不是直接给出扩散系数。看到通道是一回事,量化扩散有多快是另一回事。三维等值面看通道直观,有时二维切片更容易比较不同区域的占据强弱:继续用同一个 VolMap 数据,新建 representation 用切片显示,颜色方法改为 BWR,再在 Trajectory 里手动设置 Color Scale Data Range。
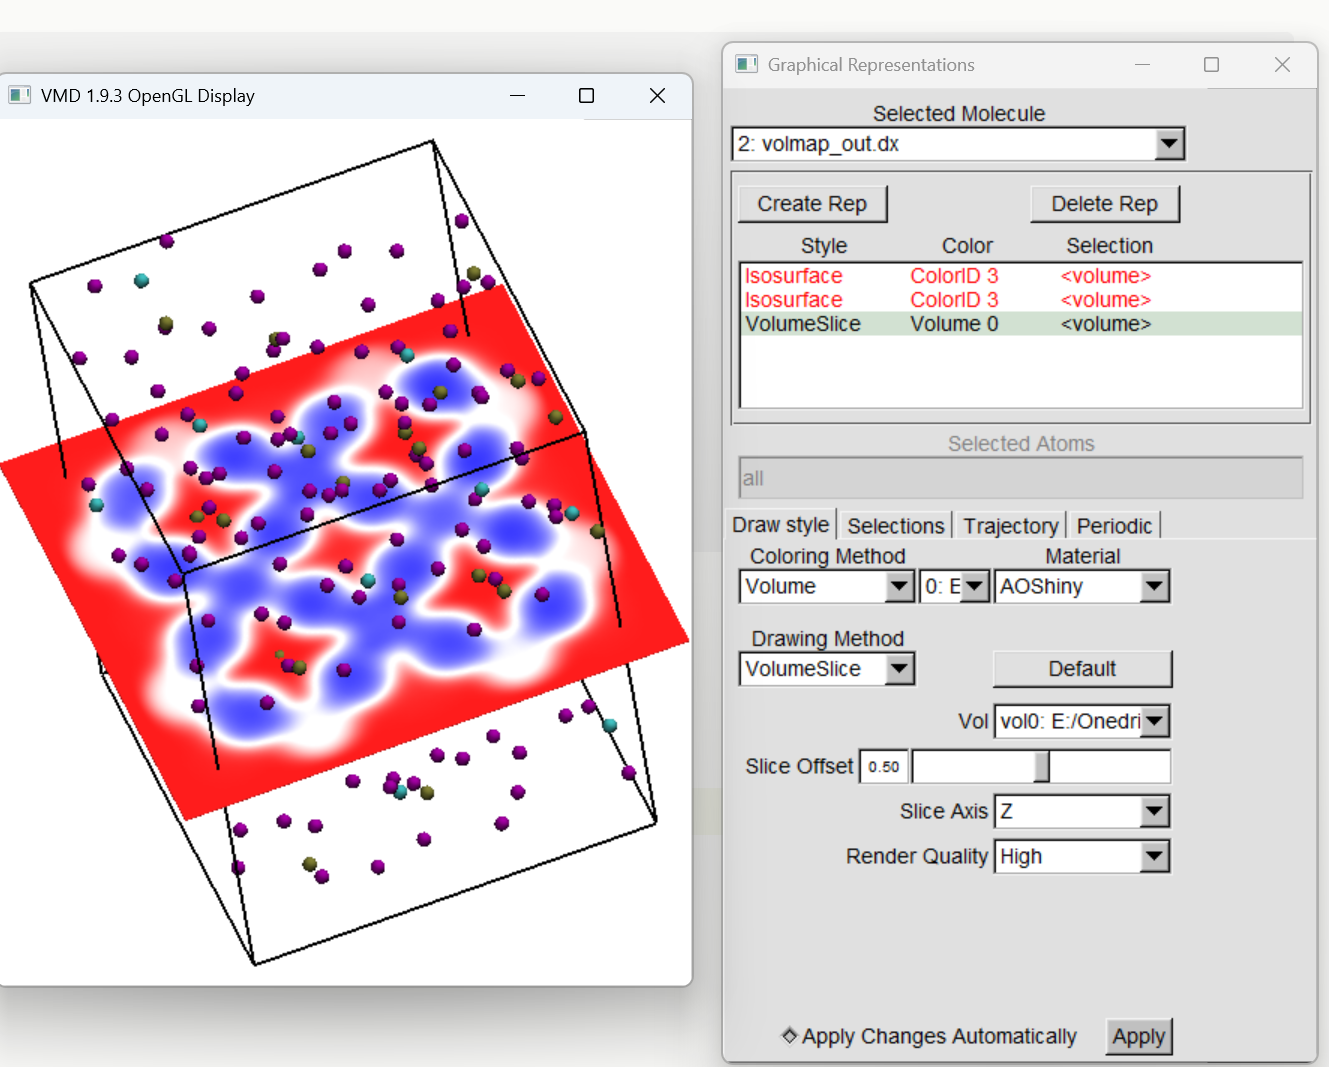
无头(ssh 连接)服务器上想渲染视频的话,先让 VMD 在命令行模式下跑脚本:
1 | vmd -dispdev text -e render_test.tcl > render_test.log 2>&1 & |
Tachyon 渲染:
1 | /path/to/vmd/lib/tachyon_LINUXAMD64 \ |
图片序列转视频:
1 | ffmpeg -y \ |
也可以用 OVITO 渲染,效果不错:
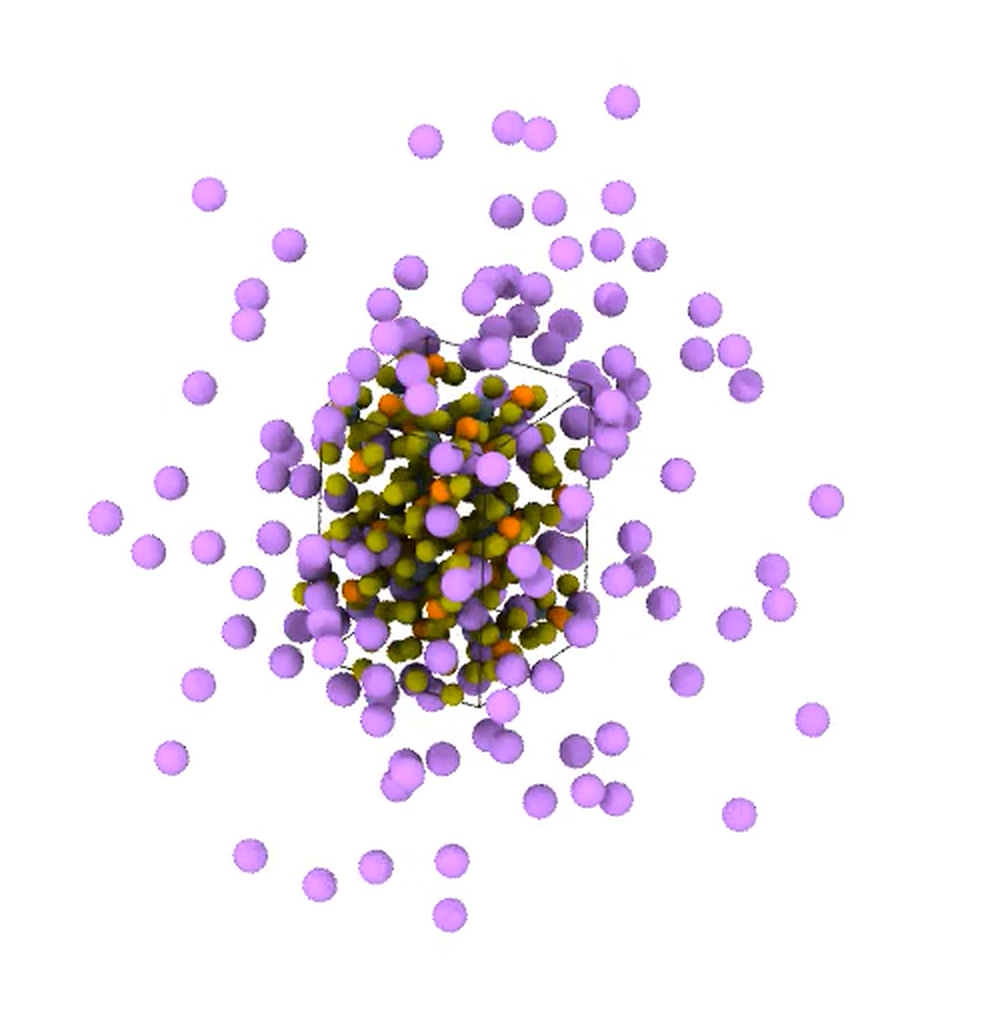
不过看只是准备,真正要做的还是算。输运性质(扩散、黏度、电导率……)描述的是质量、动量、热量或电荷在体系中迁移的快慢。平衡分子动力学(EMD)最方便的地方在于:一条平衡 MD 轨迹,通过不同的后处理方法就能得到多种输运性质,不需要主动施加外场或改变边界条件,那是 NEMD 的路子。当前这套 LGPS 分析主要还是 EMD。
在 Living J. Comp. Mol. Sci. 2019, 1(1), 6324 的框架下,很多输运系数都可以写成 Green–Kubo 形式,即时间关联函数的积分:
也可以写成等价的 Einstein 形式,即位移平方随时间增长率的极限:
两者在理论上完全等价,推导不难(两重积分展开),但在实际数值分析上各有侧重。对于自扩散系数(或者叫示踪扩散系数,与之相对的是集体扩散系数),Einstein/MSD 方法最直观,也通常更方便:
Green–Kubo 则从速度自相关函数(VACF)积分:
可以把它们理解成两把测同一个量的尺子:Einstein 看位置走了多远,对应 MSD 的长时间斜率;Green–Kubo 看速度记忆怎么衰减,对应 VACF 的积分。
落实到最直观的 MSD 上,算之前需要先统一几个容易混的词,之前确实把"lag"和"相邻时间原点之间的间隔"搞混过🤣。为了以后不再把自己绕晕,这里统一记号:
所谓"多时间原点",就是同一个
随着
当前用的命令是:
1 | mlipx analyze raw/trajectory.traj msd \ |
它会计算 Li 在不同方向上的 MSD,并以非移动骨架作为参考去掉整体漂移。各方向的扩散系数分别是
xyz 曲线最高是数学上自然的结果,不能据此说"三维扩散最快"。判断各向异性时真正应该比较的是
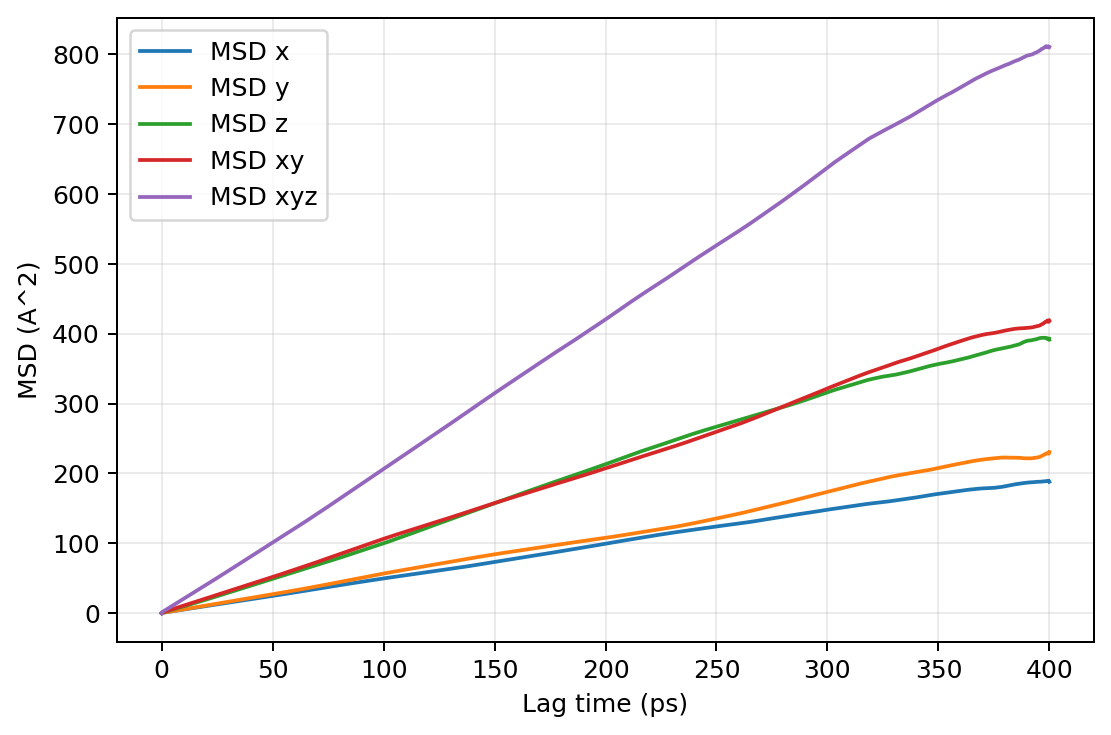
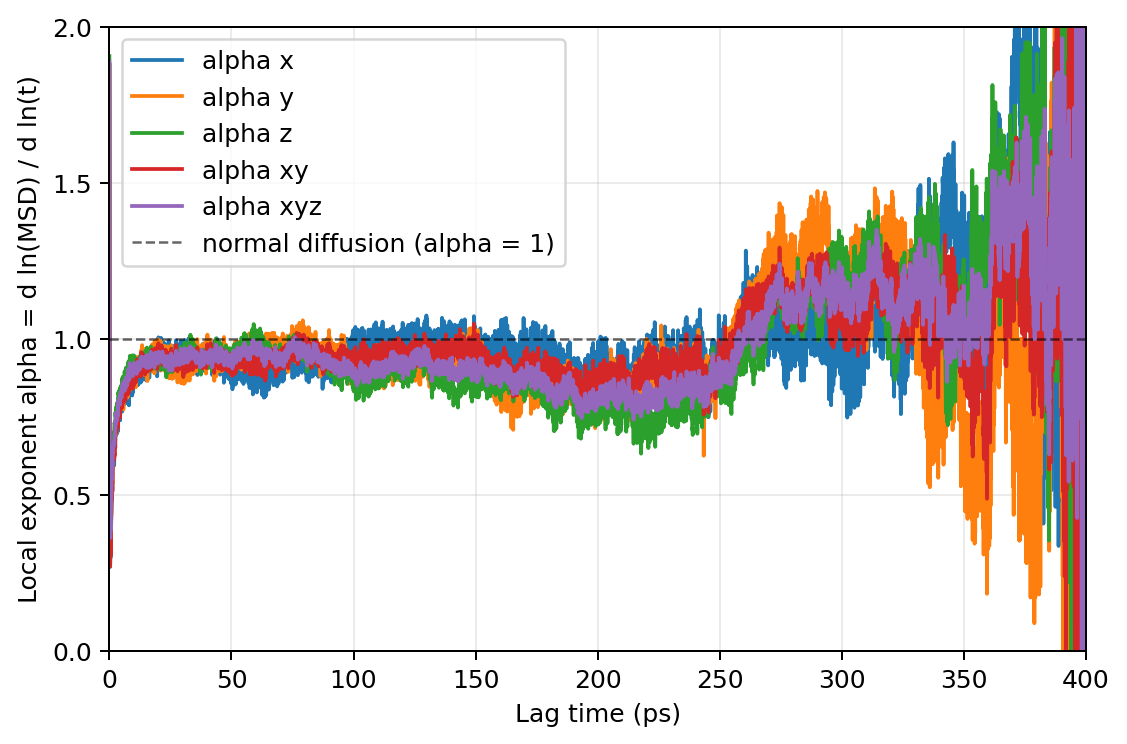
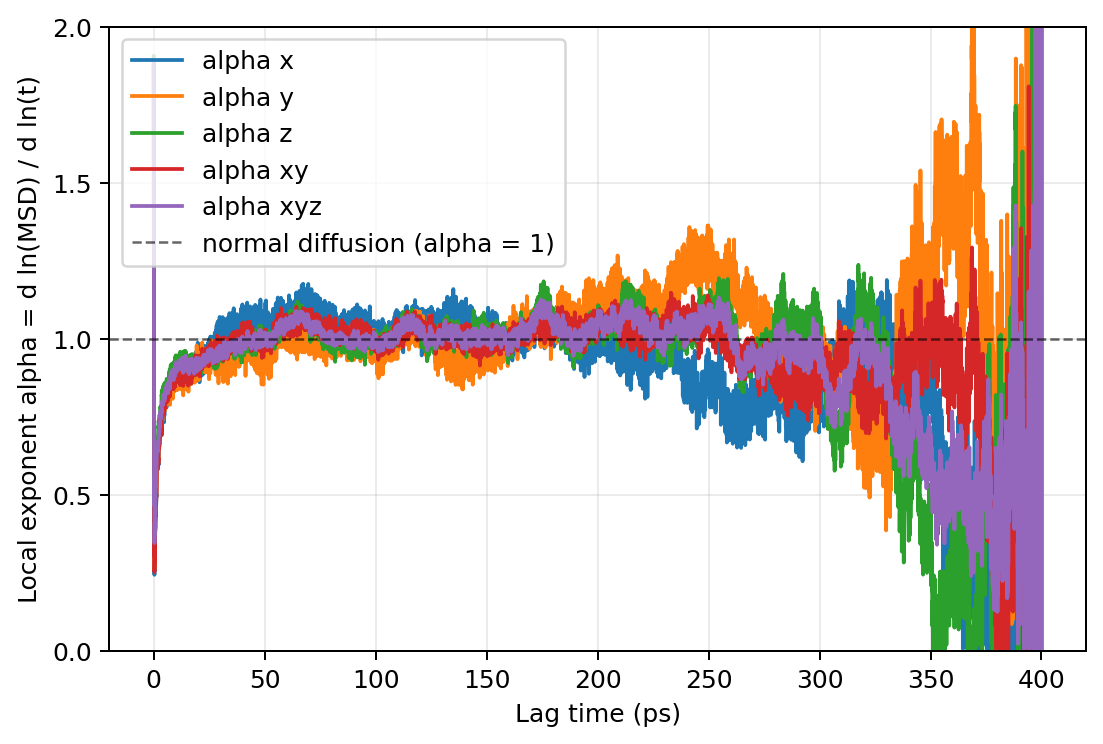
有了 MSD,下一个问题是哪一段才是"正常扩散区",也就是可以放心用来拟合扩散系数的那段。进入正常扩散后
应当接近 1。可以粗略理解:
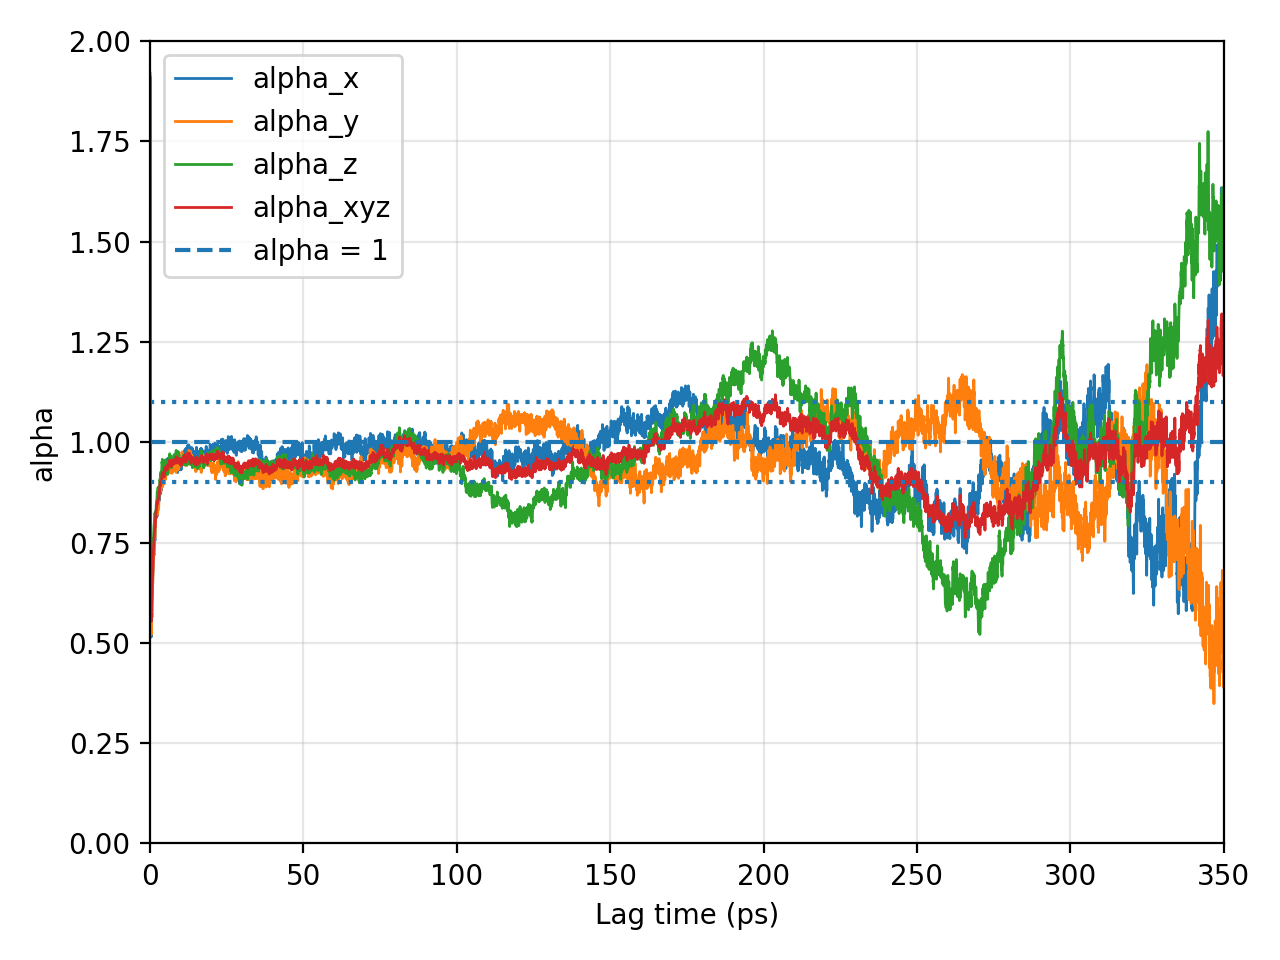
对当时的 UMA 数据,候选正常扩散区大约从几十 ps 开始,到约 200 多 ps;再往后,
于是就需要一个最朴素的诊断工具:OLS,普通最小二乘法。过程说白了就是,先从 MSD 曲线和
OLS 给出斜率和截距,从斜率得到
msd --fit-start-ps --fit-stop-ps 给出的 D_diagnostic 就属于这种普通线性拟合:
1 | mlipx analyze raw/trajectory.traj msd \ |
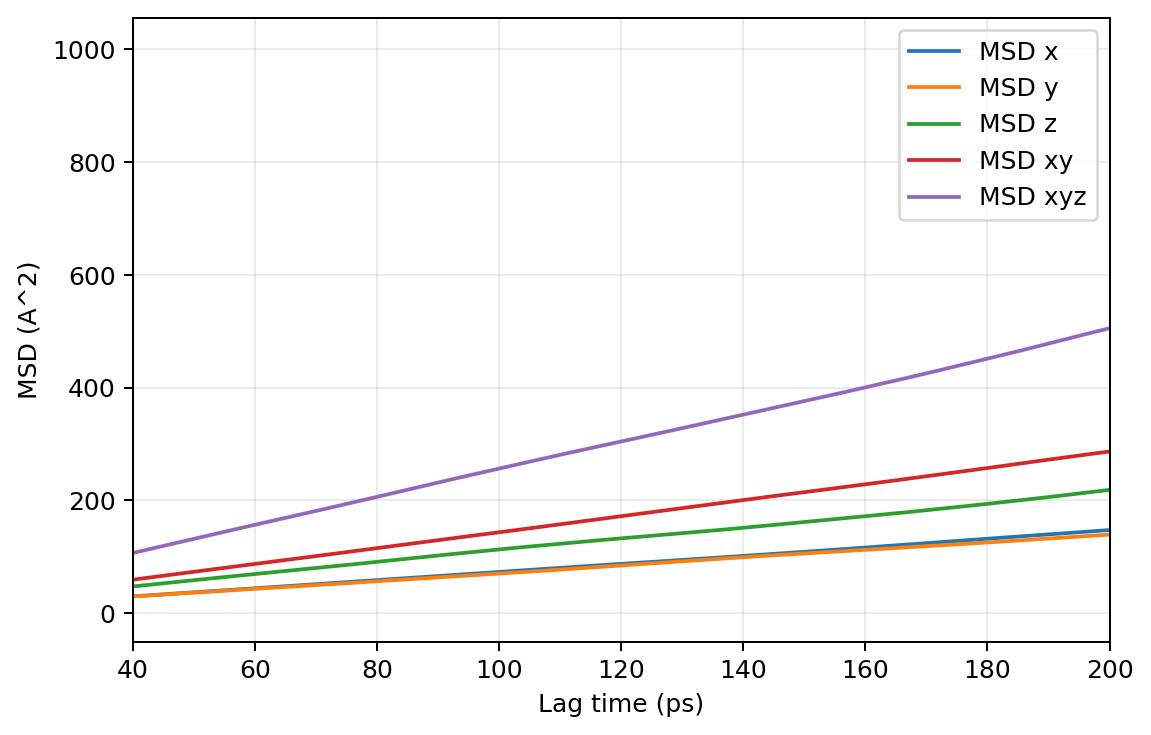
这里有个小插曲值得记下来。最初偷懒,直接用全部时间画出的 MSD-Time 曲线做 OLS,得到的自扩散系数是
OLS 最大的优点是简单、快,很适合给"斜率的点估计"、判断线性区和做敏感性测试。**但它不能简单套教科书 OLS 误差公式,去声称得到了可靠的扩散系数统计不确定度。**一篇方法学文献 J. Chem. Theory Comput. 2025, 21, 79−87 详细讲了这件事,后面还会回到它。
有了这个快速工具,第一件要做的事就是检查拟合窗口敏感性。UMA 800 K 测了三个窗口(20–180、40–200、60–220 ps):
| 拟合区间 |
|
|
|
|---|---|---|---|
| 20–180 ps |
|
0.961 | 0.999895 |
| 40–200 ps |
|
0.977 | 0.999849 |
| 60–220 ps |
|
0.990 | 0.999547 |
三个合理窗口给出的
只要在合理的 diffusive regime 内移动窗口,UMA 的
基本不变。
后续就把 40–200 ps 作为保守、居中的工作窗口。
不过窗口稳定,并不等于轨迹长度一定足够。这是两个不同的问题,很容易混在一起:fitting-window convergence 问的是同一条完整轨迹换不同 lag 拟合区间,
1 | mlipx analyze raw/trajectory.traj msd \ |
这里固定 20–50 ps 拟合区间,不是为了报告最终
OLS 的局限也得说一说。它本身没有错,问题在于教科书里 OLS 对"斜率误差"的简单公式有统计前提,而 MSD 数据恰好很容易违反这些前提。
第一件麻烦事是 MSD 点彼此相关。
第二件麻烦事是不同 lag 的方差不一样。长 lag 能用的 time origins 更少,因此 MSD 尾部通常比前面更吵,
更认真的做法是 kinisi,一个 Python 包。它的核心并不是发明另一个扩散系数,而是仍然使用 Einstein/MSD 的长时间线性关系,但更认真地处理 MSD 的统计相关性和不确定度。先把几种方法放在一起看:
| 方法 | 解决了什么 | 还剩什么问题 |
|---|---|---|
| OLS(最小二乘法) | 最简单地拟合斜率 | 忽略异方差,也忽略不同 lag 之间的相关性 |
| WLS(加权最小二乘法) | 根据各点方差加权,处理异方差 | 仍忽略 lag 之间的协方差 |
| GLS(广义最小二乘法) | 同时使用完整协方差矩阵 | 理论很好,但完整协方差通常难从有限轨迹直接获得,成本极高 |
| 近似贝叶斯方法 / kinisi | 用解析近似描述 MSD 协方差,并输出
|
仍要求用户先找到真正的长时间扩散区 |
线性模型仍然是
这篇方法论文的关键想法是:长时间进入正常扩散区之后,不同体系虽然微观机制不同,但在重新标度后会表现出类似的扩散统计结构。于是可以用长时间自由扩散极限下可解析的 MSD 协方差结构来近似真实材料中的协方差,再利用实际轨迹对其中的方差尺度进行参数化。论文用 c-LLZO 做了真实固态电解质验证:1536 个原子、448 个 Li、700 K、6 ns、NVT,再把长轨迹拆成很多统计等效的有效轨迹进行验证。作者发现,即使对只有约 28 个移动 Li、约 500 ps 的有效轨迹,单轨迹方法得到的不确定度估计也与多轨迹统计的真实分布相当吻合。
这给了我一个很重要的认识:
kinisi 的价值不是替代 MSD,而是把"MSD 斜率是多少"推进到"这个斜率到底有多不确定"。
kinisi 最终会给出 posterior mean、posterior median、posterior standard deviation 和 95% credible interval。这里严格说是 Bayesian credible interval(后验可信区间),不能和频率学派的 confidence interval(置信区间)混成一个词,虽然在很多实际场景下它们的数值区别不大。
到这里终于可以把 mlipx 的两个命令彻底分开😇。msd 用来做初步的快速诊断:正确计算 multiple-time-origin MSD,看 x/y/z 各向异性,看
transport,用 kinisi 给
1 | mlipx analyze vasp/XDATCAR transport \ |
这条命令里几个参数很容易混。--fit-start-ps 40 表示从 40 ps 开始,认为进入用于拟合
--lag-stop-ps 200 表示 kinisi 最大只分析到 lag = 200 ps。所以当前实际用于扩散回归的区间就是 40–200 ps,正对应前面通过 MSD、
--lag-step-ps 2 这个参数不是 MD timestep,不是 trajectory 保存间隔,也不是把原轨迹每隔 2 ps 抽一帧。它只是告诉 kinisi:不需要分析每一个 0.01 ps 的 lag,只取 2, 4, 6, …, 200 s 这些 lag 即可,原始完整轨迹和其中可利用的 time origins 仍然保留。为什么要这样做?因为 mlipx 自带的 FFT MSD 可以很快地算完所有 lag,但 kinisi 还需要建立和处理 MSD 的协方差结构,如果把 400 ps / 10 fs 保存间隔对应的约 40000 个 lag 全塞进去,计算会明显更昂贵(实测耗时会显著增加)。何况 MSD 上的点来自同一批 Li、同一条 trajectory,共享大量运动历史,本来就高度相关,稀疏取点是合理的。
实际跑起来是这个样子(800 K,PowerShell 下):
1 | (mlipx-workspace) PS D:\mlipx\results\800(Langevin)\uma> mlipx analyze .\raw\trajectory.traj transport --mobile Li --charge 1 --drift-reference nonmobile --positions-convention wrapped --frame-interval-fs 10 --temperature 800 --fit-start-ps 40 --lag-step-ps 2 --lag-stop-ps 200 --random-seed 0 |
lag grid 到底取多粗合适?UMA 700 K 的测试给出了参考。用 1 ps lag grid 得到
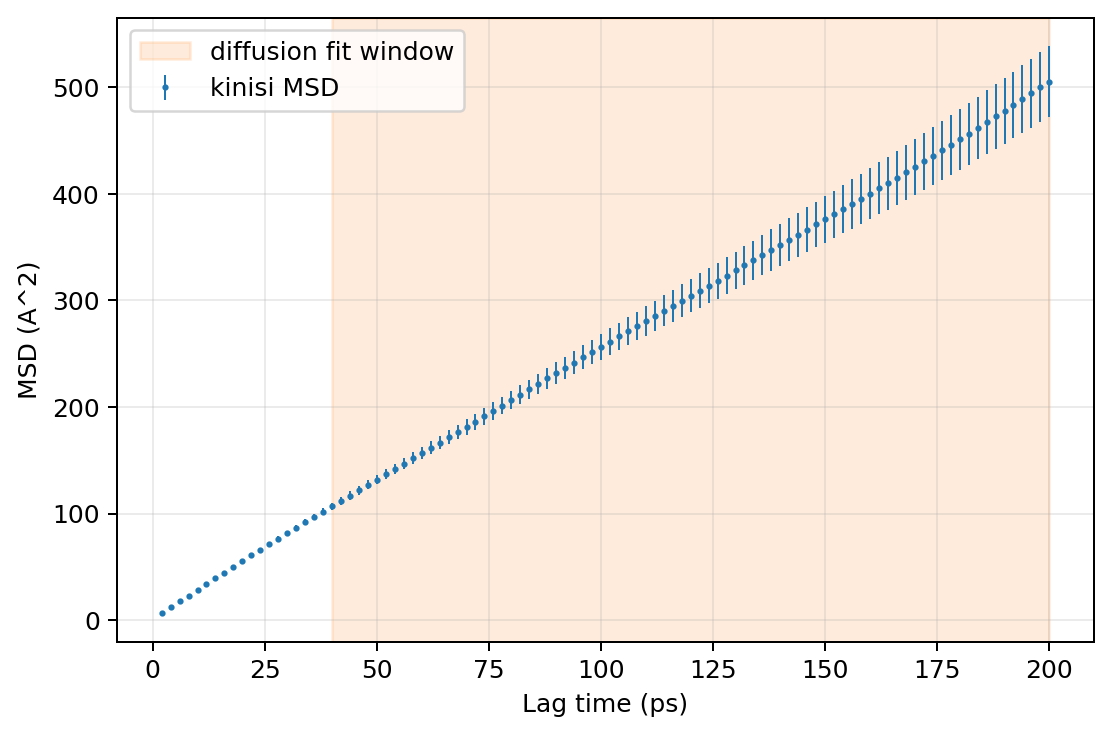
95% 后验可信区间下的数据是:Nernst-Einstein 方程(未考虑锂离子间协同作用对迁移的影响)计算出的离子电导率
D_posterior_cm2_s)
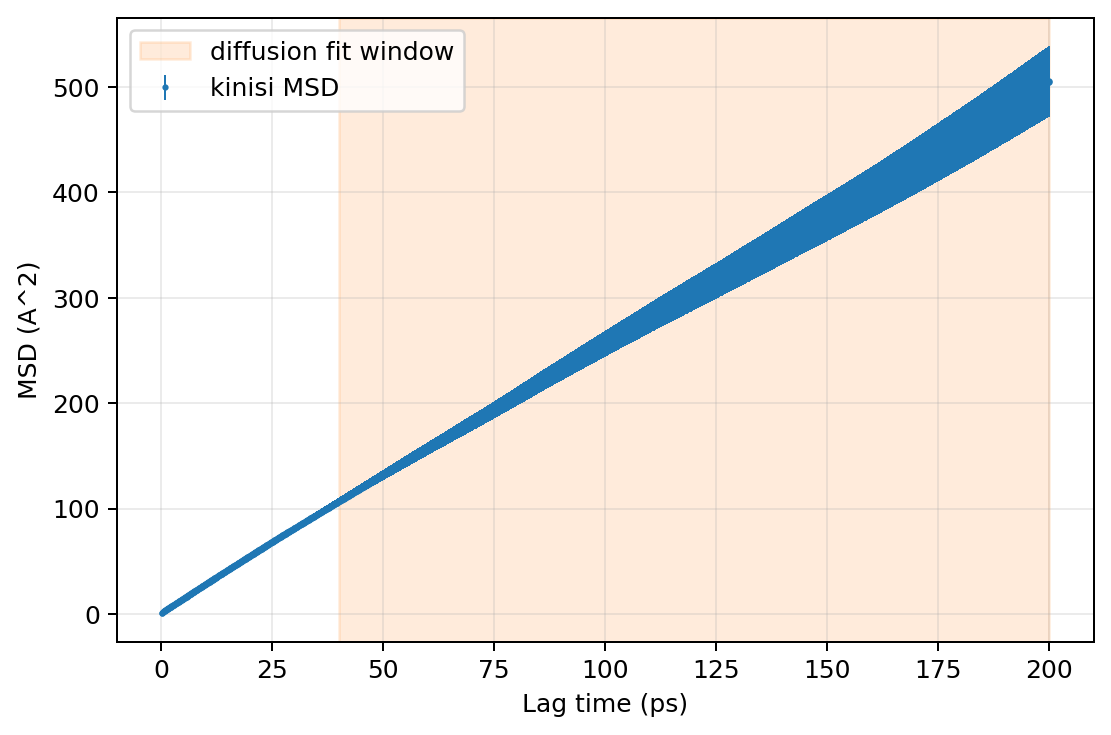
还有一件让人放心的事:前面 OLS 40–200 ps 得到的
msd 看曲线选区间,再用 transport 配合适当稀疏的 lag-step 做正式的统计推断。后者给出的核心结果不是"另一种 MSD",而是在同样的长时间扩散物理图像下,对
¶通用势的横向对比
自己训练势的路暂时走不通,就换成现成的通用机器学习势,把 LGPS 交给它们各跑一遍。参与比较的有 UMA(uma-s-1p2p1.pt)、MACE(mace-mh-1)、DPA(DPA-3.2-5M.pt)、GRACE(GRACE-2L-SMAX-OMAT-large),统一 800 K 和 700 K、400 ps、1 fs / 400000 步:
| 类型 | 时间 | 步长/步数 |
|
平均
|
自扩散系数
|
平均
|
|---|---|---|---|---|---|---|
| 800K: uma-s-1p2p1.pt | 400 ps | 1fs/400000 |
|
|
|
|
| 800K: mace-mh-1.model | 400 ps | 1fs/400000 |
|
|
|
|
| 800K: DPA-3.2-5M.pt | 400 ps | 1fs/400000 |
|
|
|
|
| 800K: GRACE-2L-SMAX-OMAT-large | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: uma-s-1p2p1.pt | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: mace-mh-1.model | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: DPA-3.2-5M.pt | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: GRACE-2L-SMAX-OMAT-large | 400 ps | 1fs/400000 |
|
|
|
|
顺便说一下三个缩写的全称:DPA 是 Deep Potential Atomic,MACE 出自 Machine Learning Force Fields 一脉,UMA 是 Universal Models for Atoms。
一眼就能看出来,UMA 明显偏高:800 K 平均电导率接近 2000 mS/cm,而 MACE、DPA、GRACE 都在 900–1050 mS/cm 附近;700 K 下 UMA 也明显高于其他三家。
700 K 下 DPA 的
| 类型 | 时间 | 步长/步数 |
|
平均
|
自扩散系数
|
平均
|
|---|---|---|---|---|---|---|
| 700K: DPA-3.2-5M.pt (fit 20–180 ps) | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: DPA-3.2-5M.pt (fit 40–200 ps) | 400 ps | 1fs/400000 |
|
|
|
|
| 700K: DPA-3.2-5M.pt (fit 60–220 ps) | 400 ps | 1fs/400000 |
|
|
|
|
可以看到这时自扩散系数确实对采样比较敏感,窗口越往后移,得到的
DPA-3.2-5M.pt 是多头模型,800 K 的时候设定 Domains_SSE_PBE 为 head,但是 700 K 忘设定了,极其严重的低级错误😢。用正确的 head 重跑了 700 K,
于是 700 K 的总体格局大概是:
1 | UMA |
UMA 为什么是那个离群的异类?🐱🤔
再看看之前跑的旧数据,也是 NVT 系综、Langevin 热浴,但有些步长是 0.5 fs 的,拟合区间统一使用 20 ps–125 ps:
| 类型 | 时间 | 步长/步数 |
|
平均
|
自扩散系数
|
平均
|
|---|---|---|---|---|---|---|
| 800K: uma-s-1p2p1.pt | 200 ps | 0.5fs/400000 |
|
|
|
|
| 800K: mace-mpa-0-medium.model | 200 ps | 1fs/200000 |
|
|
|
|
| 800K: DPA-3.2-5M.pt | 200 ps | 0.5fs/400000 |
|
|
|
|
| 800K: GRACE-2L-SMAX-large | 200 ps | 0.5fs/400000 |
|
|
|
|
Emmm,看起来 MACE、DPA、GRACE 的结果非常接近,并且与之前 1 fs 步长的数据形成了对比。有几个不太充分的猜测:一是 1 fs 的步长过长了;二是 DPA、GRACE、MACE 能够比较准确地预测离子电导率,而 UMA 出现了问题。但这些都还说不准,需要单独验证。
MACE 这边也尝试了不同版本的基础模型。截至目前,medium-mpa-0 在 2026 年已经有固态锂电解质研究直接用它做离子电导率 MD。可用的 MACE 模型列在下面供参考(MACE-MDP 只输出偶极矩和极化率,不用于能量和力,更多信息;MACE-MH-1 的说明见 HuggingFace):
| MODEL NAME | ELEMENTS COVERED | TRAINING DATASET | LEVEL OF THEORY | TARGET SYSTEM | MODEL SIZE | GITHUB RELEASE | LICENSE |
|---|---|---|---|---|---|---|---|
| MACE-MP-0 | 89 | MPTrj | DFT (PBE+U) | Materials | small, medium, large | >=v0.3.6 | MIT |
| MACE-MPA-0 | 89 | MPTrj + sAlex | DFT (PBE+U) | Materials | medium-mpa-0 | >=v0.3.10 | MIT |
| MACE-OMAT-0 | 89 | OMAT | DFT (PBE+U) VASP 54 | Materials | medium-omat-0 | >=v0.3.10 | ASL |
| MACE-MATPES-0 | 89 | MATPES | PBE/R2SCAN | Materials | matpes-pbe, matpes-r2scan | >=v0.3.10 | ASL |
| MACE-OFF23 | 10 | SPICE v1 | DFT (wB97M+D3) | Organic Chemistry | small-off, medium-off, large-off | >=v0.3.6 | ASL |
| MACE-MH-1/0 | 89 | OMAT/OMOL/OC20/MATPES | DFT (PBE/R2SCAN/wB97M-VV10) | Materials/Molecules/Surfaces | mace-mh-1, mace-mh-0 | >=v0.3.14 | ASL |
| MACE-MDP | 10 | SPICE-α | DFT (wB97M-D3(BJ)/def2-TZVPP) | Organic systems | mace-mdp-model | >=v0.3.16 | ASL |
后来补了 600 K 下四组数据,同样 Langevin 热浴、1 fs 步长、400 ps:
| 类型 | 拟合窗口 | 平均温度 | 步长/步数 |
|
平均
|
|
平均
|
|---|---|---|---|---|---|---|---|
| 600K: uma-s-1p2p1.pt | 40–200 ps | 600.537 | 400000 |
|
|
|
|
| 600K: mace-mh-1.model | 40–200 ps | 598.716 | 400000 |
|
|
|
|
| 600K: DPA-3.2-5M.pt | 40–200 ps | 600.168 | 400000 |
|
|
|
|
| 600K: GRACE-2L-SMAX-OMAT-large | 40–200 ps | 596.814 | 400000 |
|
|
|
|
有趣的是,UMA 的结果在 600 K 下看上去"正常"了不少,降下来了,四个模型挤到了同一个量级。但把三个温度连起来看,UMA 的温度依赖出现了一个非常大的拐弯。先排除"600 K 这一个点采样/窗口不稳"的可能:20–180 ps 窗口
把三个温度的数据整理成 Arrhenius 分析:
| 模型 | 三点 apparent
|
|
600→700 K (
|
700→800 K (
|
|---|---|---|---|---|
| UMA | 0.339 eV | 0.890 | 0.514 eV | 0.092 eV |
| MACE | 0.184 eV | 0.998 | 0.172 eV | 0.204 eV |
| DPA | 0.189 eV | 0.997 | 0.204 eV | 0.167 eV |
| GRACE | 0.217 eV | ~1.000 | 0.217 eV | 0.218 eV |
MACE、DPA、GRACE 三家的 Arrhenius 图都很直,分段活化能和三点拟合也对得上;UMA 的两段斜率却差得太大,0.339 eV 的三点拟合没什么意义。用 600 K 和 800 K 两个端点画一条 Arrhenius 直线,插值预测 700 K,大概
会不会是 700 K 采样异常?重复跑了两条不同种子的 UMA 700 K 轨迹(顺便一提,在一台 RTX 4090 上跑同一个模型只需要约 6.5 h,显著快于 V100 的约 14.5 h):
| 标识 | Seed |
|
95% CrI (cm²/s) |
|
|---|---|---|---|---|
| original | 1986240779 |
|
|
698.76 |
| again1 | 1858715308 |
|
|
697.26 |
| again2 | 1201954440 |
|
|
699.77 |
UMA 700 K 的高扩散在三个独立 seed 里是可重现的。结论是:uma-s-1p2p1.pt(小模型,1.2.1 版本)在 600–800 K 会表现出可重复的、显著偏离单一 Arrhenius 关系的扩散系数。
之前考虑速度和显存,用的是小模型,这次试试 uma-m-1p1.pt(1.1 版本 medium)。不过在 V100 上测试时开 turbo 模式会炸显存,只能在 default + activation_checkpointing 下计算,粗估 400 ps 需要 >100 h。先在 4090 上跑一下,并对比两个 UMA 模型的变胞优化结果:
| 模型 | V_eq (ų) | ΔV vs DFT V₀ | a (Å) | b (Å) | c (Å) |
|---|---|---|---|---|---|
| UMA-S | 8889.8 | +12.36% | 18.05 | 18.10 | 27.20 |
| UMA-M | 7969.7 | +0.73% | 17.24 | 17.76 | 26.05 |
| MACE | 8007.3 | +1.20% | 17.28 | 17.79 | 26.06 |
| DPA-SSE | 7945.7 | +0.43% | 17.24 | 17.75 | 25.98 |
| GRACE | 7929.3 | +0.22% | 17.21 | 17.75 | 25.97 |
UMA-S 的晶胞偏大了 12%,而 UMA-M 和其他三个模型都在 1% 以内。这大概就是 UMA-S 扩散系数偏高的一部分原因。
遗憾的是在 RTX 4090 24 GB 上开 turbo 依然 OOM:
1 | 2026-08-18 13:12:50 [ERROR] CUDA out of memory. Tried to allocate 256.00 MiB. |
UMA-M 跑完 400 ps 估计得 30 h+,暂时搁置。后来给 mlipx 增加了集体离子电导率计算功能,但 400 ps 的自扩散收敛得很好,集体扩散系数却没有收敛,增大到 1000 ps 依然如此,就此作罢。这条线索后面谈 Nernst–Einstein 时还会回来。
¶采样与不确定度
MSD 是一条漂亮直线,只能说明在这条轨迹中观察到了近似正常扩散;它并不能证明整个相空间已经被充分采样。这是读 uncertainty / sampling best-practice 文献时最重要的收获之一:
证明"采样很好"很难,但发现"采样明显不好"相对容易。
最基础的零阶检查,是看一些全局量是否还在系统性漂移:势能、温度、体积、密度、结构性指标。如果它们还在持续单向漂移,说明至少不能把整段当作平衡生产数据;如果它们已经围绕稳定均值涨落,也只能说"没有看到明显坏信号",并不能证明已经遍历了所有重要状态。
一段模拟分为平衡期和生产期,轨迹开头往往带着初始构型和初始速度的记忆,因此通常需要舍弃一段 equilibration,只对后面的 production 数据做平衡态分析。一个比较朴素但重要的检验是:==如果最终观测量对"我从哪里开始算 production"非常敏感,那说明还需要更多采样或更仔细的平衡检查。==一些统计方法会通过寻找"使剩余生产段有效独立样本数最大"的切点来估计平衡时间,但这种方法也不是万能的:如果整个模拟根本没有跨越重要的亚稳态,它仍可能把你困住的最后一个盆地误认为"已经平衡"。
MD 轨迹的相邻帧本来就不是独立样本。相关时间可以粗略理解为"系统要过多久,才基本忘记之前的状态",总模拟时长除以相关时间,可以给出有效独立样本数的数量级。对普通时间序列,可用自相关函数、块平均等方法估计有效样本数。块平均的思想是把轨迹切成越来越长的块,每块算一个平均值;块足够长以后,不同块之间逐渐去相关,估计的不确定度应该趋向平台。如果块大小变化时误差还一直变,说明块还不够独立。
多时间原点可以让一条 trajectory 的 MSD 更平滑,但重叠的 time origins 并不是许多条真正独立的模拟。真正独立的 replica 通常至少要使用不同的初始速度随机种子,最好还考虑不同的平衡初态。它们有两个价值:一是能更直接地看 run-to-run 波动,同样的体系、温度和模型,换一套独立初始条件,最终
不确定度量化方面有几个值得一记的工具,来自 Grossfield 等关于采样质量和 uncertainty quantification 的综述。
标准差和标准误不是一回事。样本标准差描述数据本身有多分散,平均值的标准误描述"均值这个估计量"有多不确定。如果样本独立:
但 MD 数据通常相关,所以不能把每一帧都当成独立的
自相关可以给出有效样本数。对于平稳时间序列:
直观上就是问:表面上存了很多帧,但真正相当于多少个独立样本?
Bootstrap 的基本思想是从已有独立样本中有放回抽样,组成许多"合成数据集",每个数据集重新计算目标量,用得到的经验分布构造区间。对于相关时间序列,不能直接把每帧当独立样本 bootstrap,通常要先处理相关性,例如先分块,再以块为抽样单位。
还有一种"暗不确定度":如果多条独立模拟各自的内部误差棒都很小,但不同模拟的结果彼此又明显不一致,说明还存在模拟内部误差模型没有解释的 run-to-run 变异。这类差异提醒我:
单轨迹内部的 statistical uncertainty 不等于整个项目的全部 uncertainty。
kinisi 可以给单条轨迹内非常有价值的
Grossfield 等的综述里还有一段关于构象采样的讨论,用的是蛋白质的例子,不是直接为 LGPS 写的,但思路值得保留。传统的 RMSD-vs-time 只能告诉你体系离某个参考结构有多远,RMSD 平台并不能证明采样充分,因为许多完全不同的构型可能离参考结构具有相似 RMSD。更有信息量的是两两 RMSD 图:把轨迹中的每个快照和其他所有快照比较。如果时间上相隔很远的结构仍然多次回到相似区域,说明体系确实在反复访问已有状态;如果只发生一次不可逆的大转变,则很难证明两个状态的相对占据已经被充分采样。对 LGPS 不一定照搬蛋白质 RMSD 这套指标,值得借鉴的是那句话:
好的采样不只是"曲线看起来平了",还应该能看到重要状态被反复访问。
¶热浴与动力学
热浴对动力学的影响,是后来想得最多、也最容易被忽视的一块。之前做 MD 直接用了 Langevin,没仔细考虑过。
对于只关心平均结构、RDF、温度分布等平衡性质的场景,thermostat 的首要任务是给出正确的目标系综。但扩散、VACF、离子电导率属于动力学/输运性质,除了"采样对不对",还要问一句:thermostat 有没有不自然地改变粒子的时间演化?因此:
Velocity AutoCorrelation Function(速度自相关函数)可以很直观地理解为:过了一段时间以后,粒子"还记不记得"刚才朝哪里跑?如果
即使 NVE 中没有 thermostat,真实动力学自身也会逐渐失去速度记忆。
所以不能看到 VACF 归零就说"热浴把动力学破坏了",真正应该比较的是不同 thermostat 参数下 VACF 的形状、衰减时间以及最终输运系数是否发生系统改变。
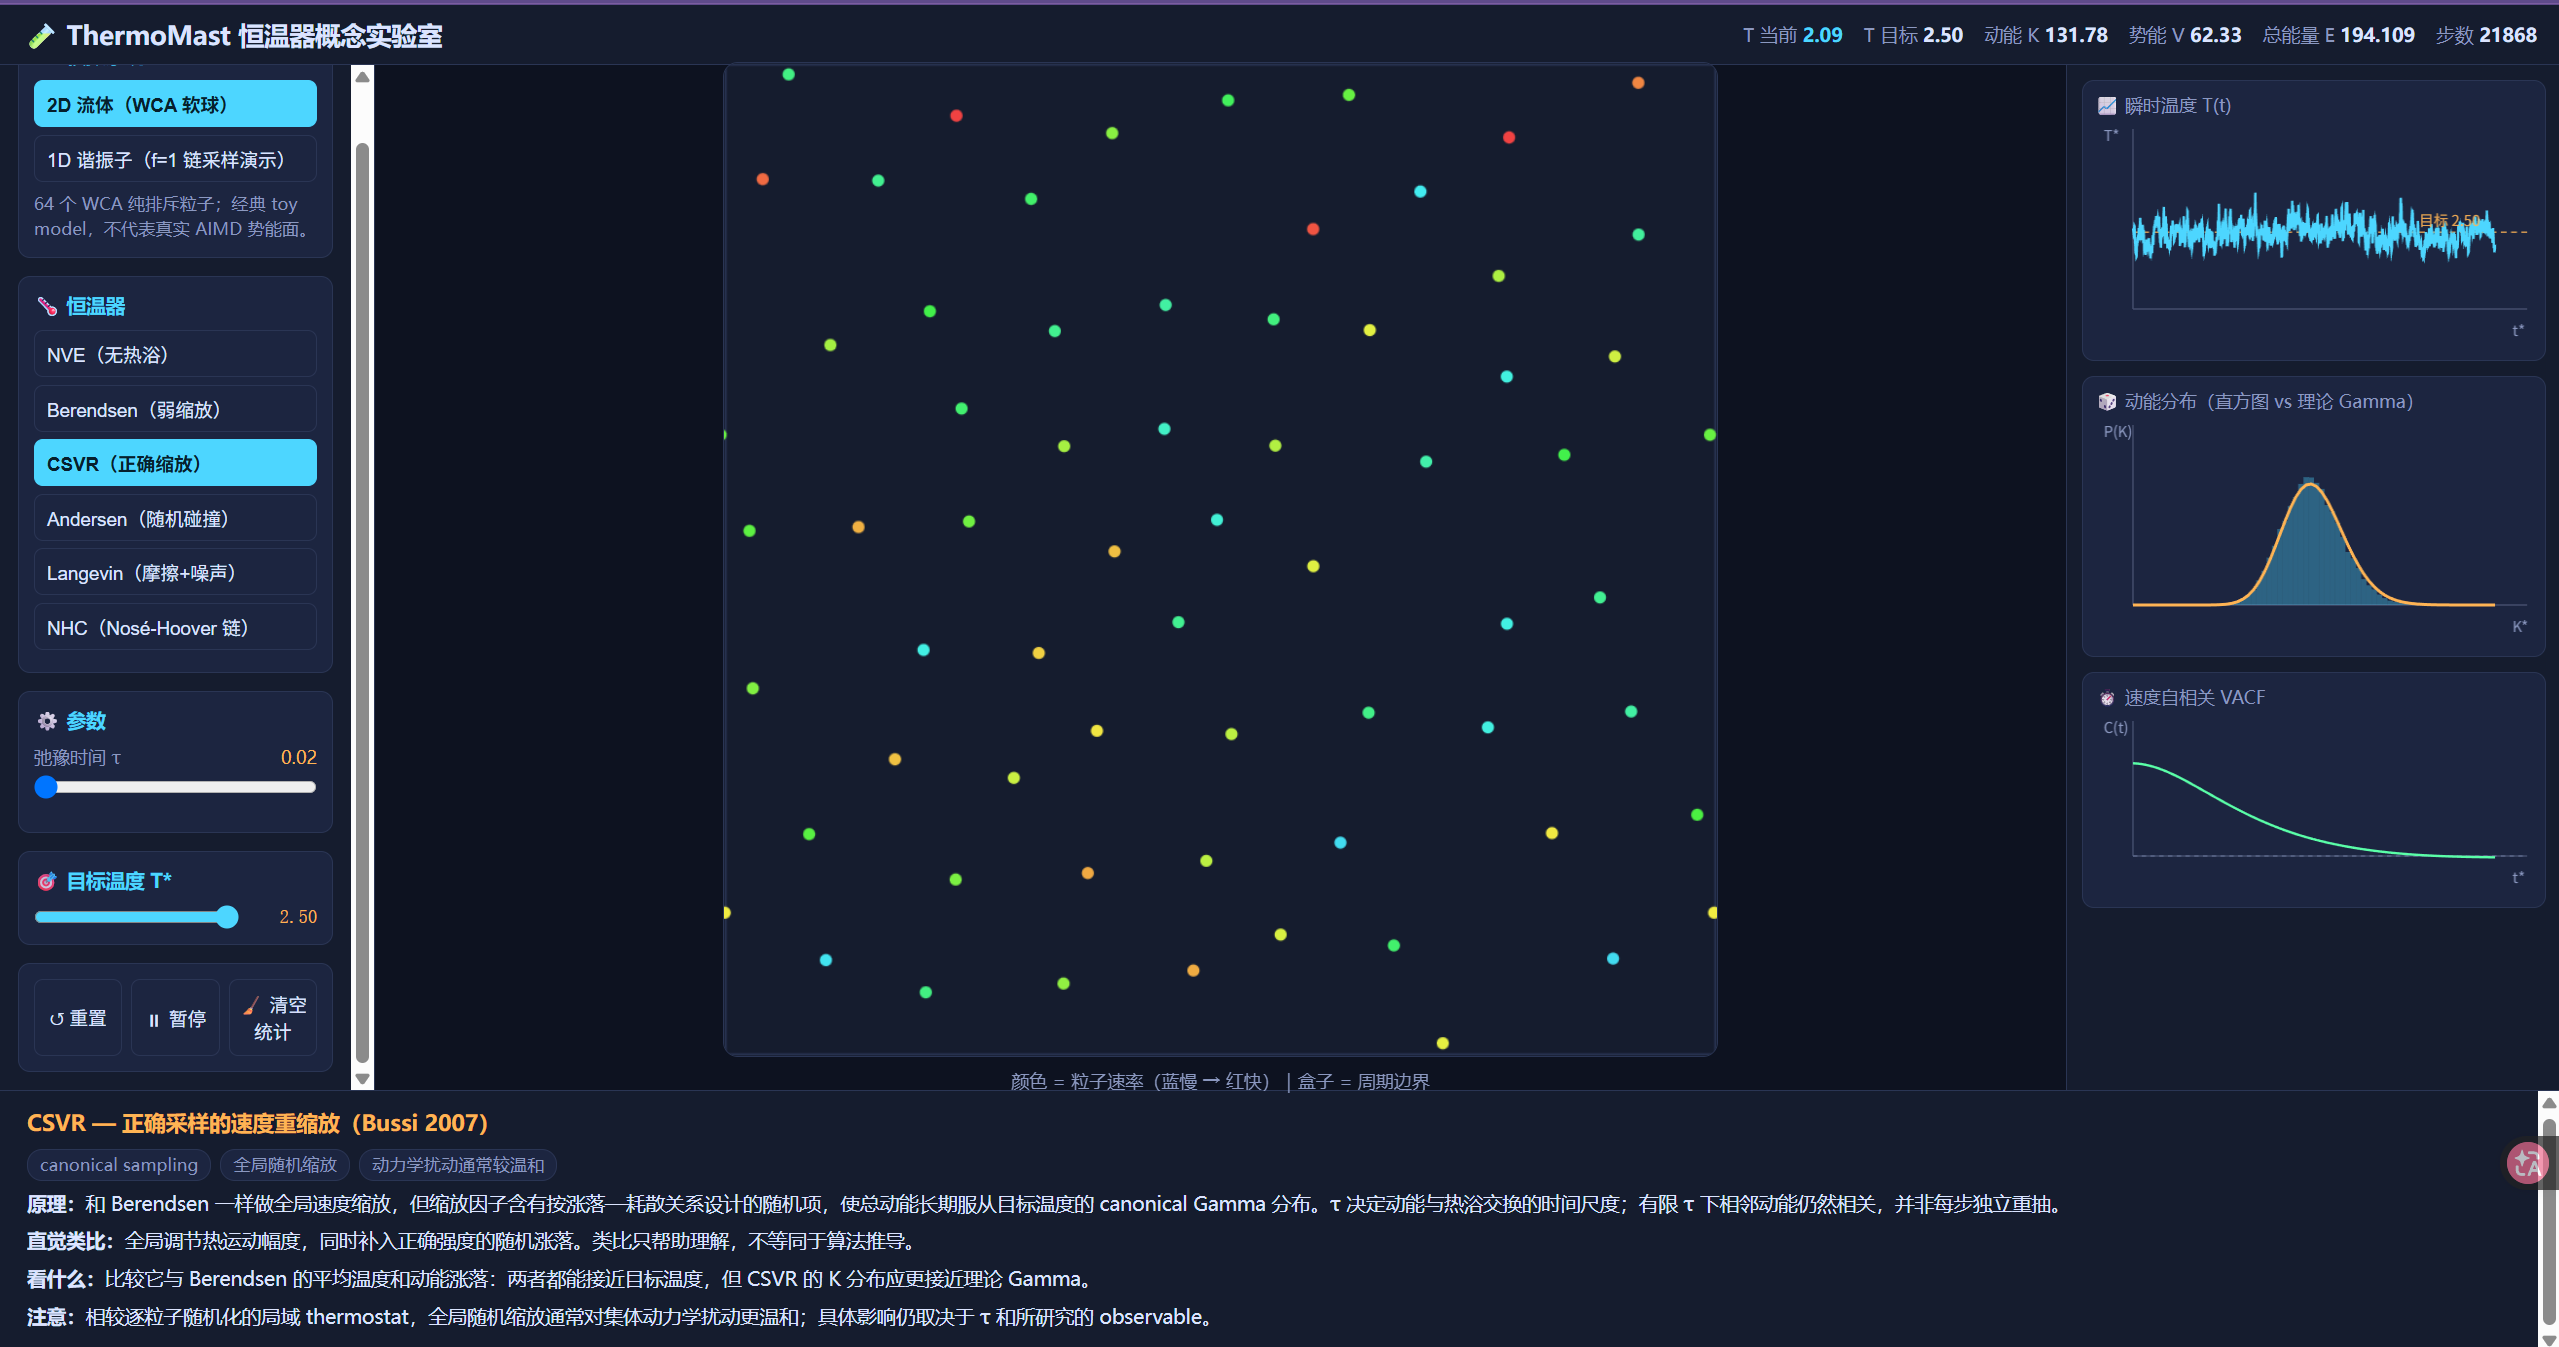
CSVR(Stochastic Velocity Rescaling)可以粗略理解为对体系总体动能做随机重标:
耦合时间
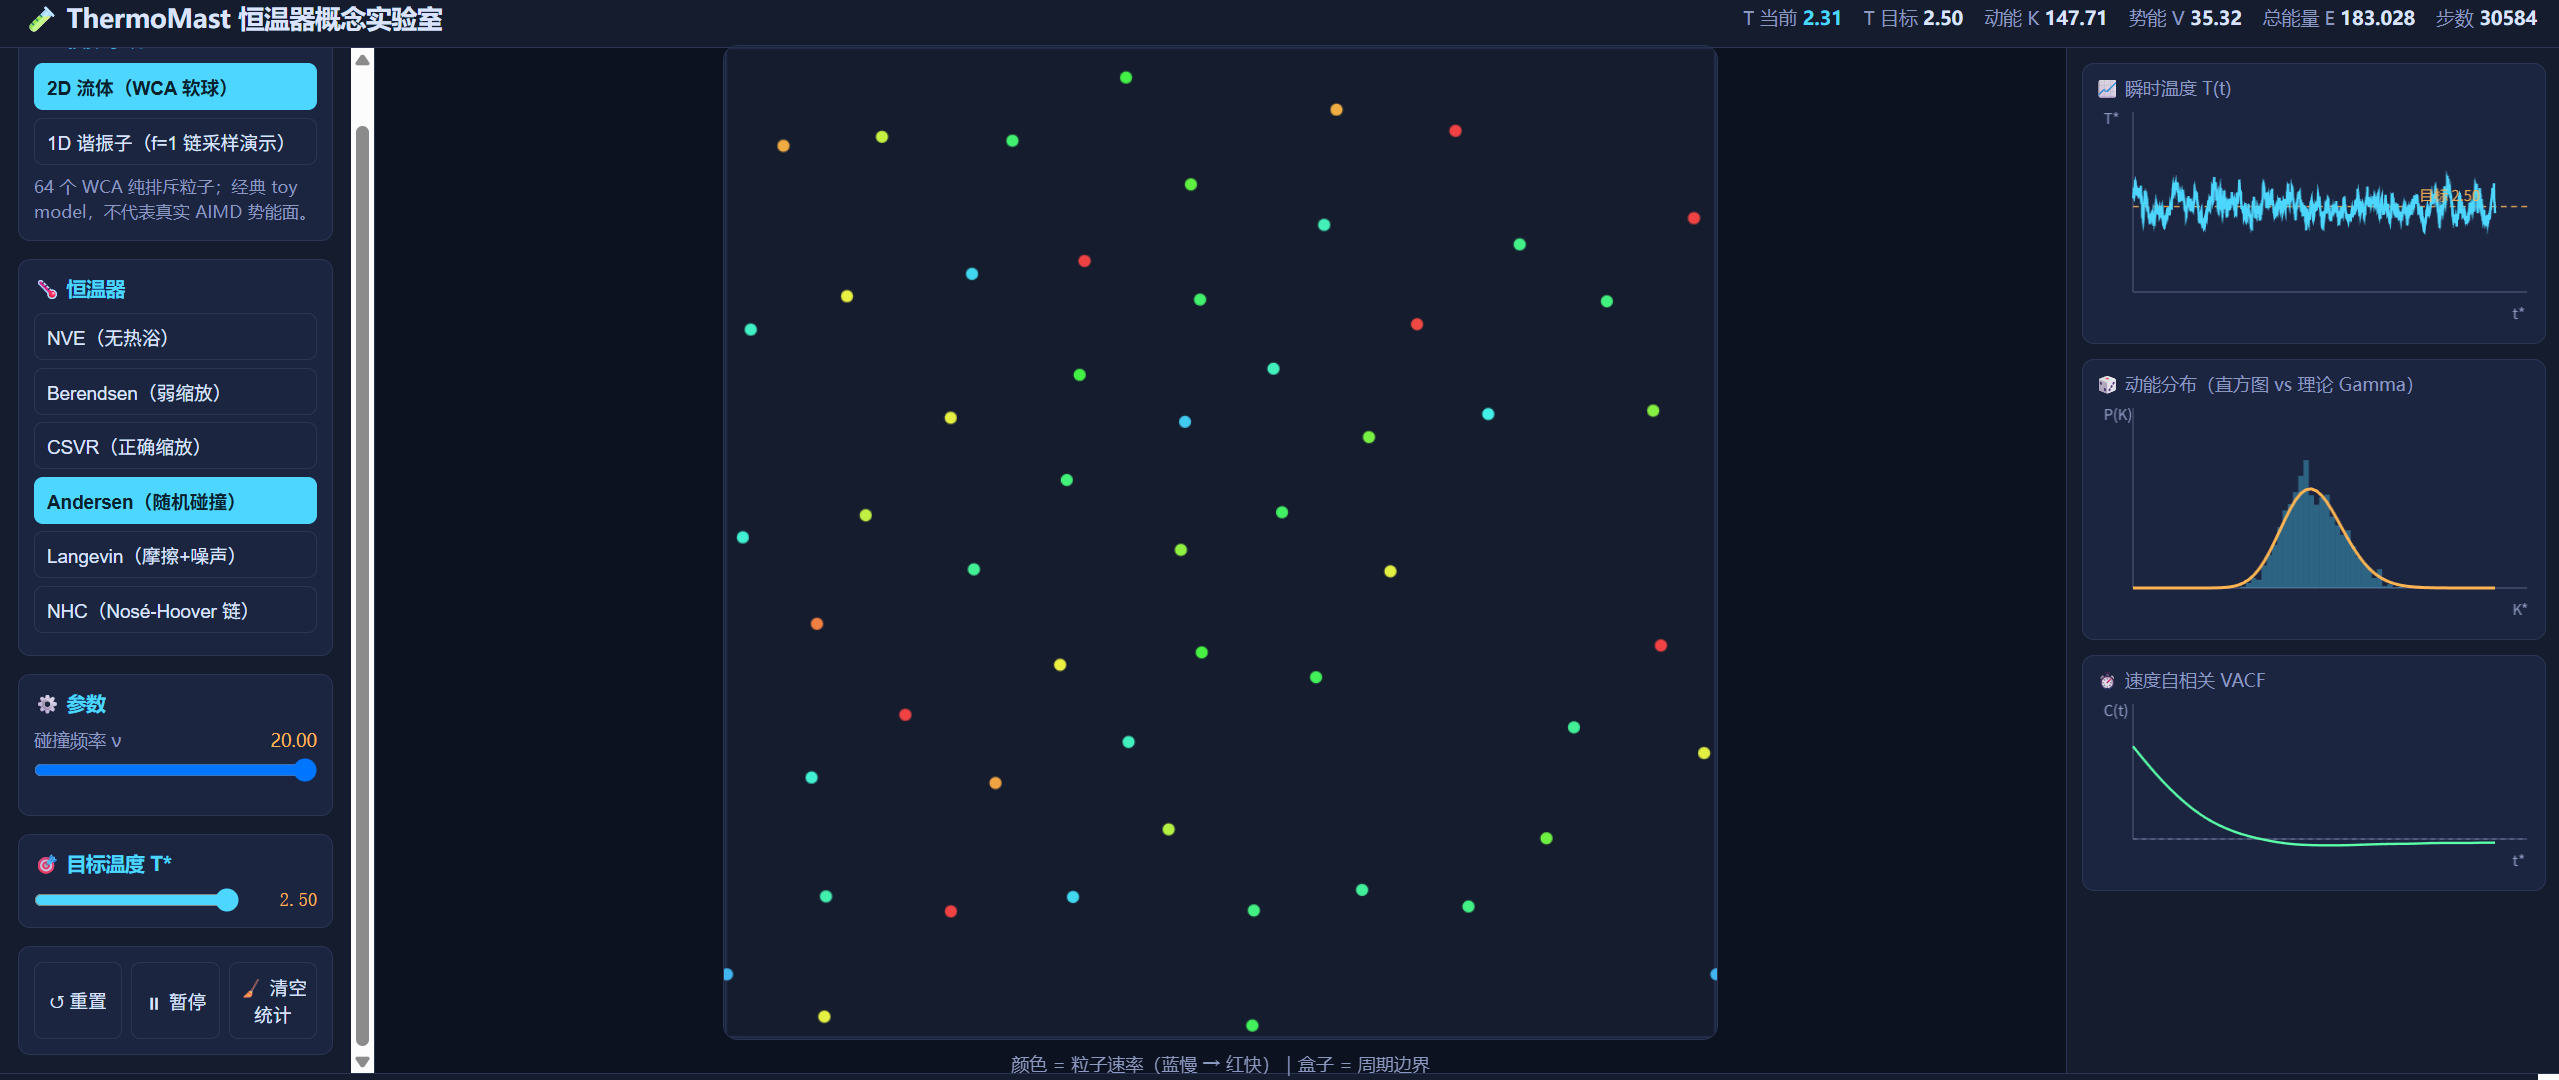
Andersen thermostat 会随机选择粒子并重新抽取速度,非常直接地破坏单粒子的速度记忆。它很容易得到正确的 Maxwell–Boltzmann 速度分布,但不适合不加判断地用于需要真实动力学信息的场景。
Langevin thermostat 同时加入摩擦和随机力。强摩擦可以让动量分布很快热化,但也可能显著阻尼真实运动。需要分清"速度分布已经正确"和"构型空间已经平衡"这两个完全不同的问题。
Berendsen thermostat 很擅长快速把平均温度拉向目标值,但它会抑制自然能量涨落,因此不能把它视为严格 canonical sampler。
Nosé–Hoover / Nosé–Hoover chain(NHC) 是确定性 thermostat。单个 Nosé–Hoover 变量在某些体系里可能有遍历性问题,NHC 通过增加 thermostat chain 改善采样。这里的耦合时间同样可以粗略理解为热浴响应时间尺度,而链长度主要影响遍历性。
目前形成的朴素认识是:CSVR、Andersen、Langevin 和 NHC 都可以设计成采样正确的 canonical ensemble,但"采样正确"不代表对所有动力学性质都同样温和(尤其是 Andersen 热浴);耦合越强,越应该检查输运性质的 thermostat sensitivity。
到底如何选择合适的热浴呢?可以参考 Basconi & Shirts, JCTC 2013。他们的体系主要是液体,不是 LGPS,所以数值结论不能直接搬过来,但方法学上的启发很有价值:不同 thermostat 对动力学的破坏程度差别很大,尤其是直接随机重置单粒子速度的方式,在强耦合下容易明显改变扩散系数和黏度;全局 thermostat 对他们研究的体系影响相对温和。对 LGPS 更合理的态度,不是争论哪一个 thermostat 在宇宙中最正确,而是:
选一个有理论根据、行为合理的 thermostat,然后对关键输运结果做 sensitivity test。
Green–Kubo 前面只是提了一句,这里补几句它在工作流里的位置。对于自扩散系数,Einstein/MSD 方法更直观,也更适合当前已有的轨迹;Green–Kubo 需要积分 VACF:
它的麻烦是 VACF 往往在非常短的时间尺度上快速变化,因此需要保存更高时间分辨率的速度数据,经验建议是至少约每 4–5 fs 保存一次速度。这和 Einstein/MSD 很不一样:MSD 关心长时间斜率,对超高频率保存位置的需求没有那么强。Green–Kubo 的一个核心诊断是积分平台:VACF 积分随积分时间增加逐渐到达平台,平台值就是
¶从自扩散到电导率
前面的 MSD 得到的是单粒子运动意义下的示踪/自扩散系数:
从自扩散系数到电导率,中间还隔着一层经常被略过的近似。最常见的 Nernst–Einstein 近似把它直接转换为离子电导率:
其中
原笔记引用的 LGPS 工作得到过
集体扩散系数也可以直接从所有载流子的总位移出发:
与自扩散系数不同,这里是先对所有离子求和位移再取模的平方,而不是各自平方再求和,因此它包含了粒子间的位移交叉关联项。mlipx 已经支持集体离子电导率计算,但如前面提到的,400 ps 的自扩散收敛得很好,集体扩散系数并未收敛,增大到 1000 ps 仍然如此,这部分暂时搁置。
还有一个参考系的问题。在 PBC 模拟中,整个体系可能出现数值上的整体漂移,对于 LGPS,更自然的做法是以相对刚性的 Ge/P/S 骨架作为参考,研究 Li 相对于骨架的运动。载流子质心速度修正:
对于 Li self-MSD,mlipx 当前的 --drift-reference nonmobile 就是在做同类思想的参考系修正:让 Li 的扩散尽量表达成"相对骨架的迁移",而不是整个模拟盒子的平移。但要区分两件事:算 self-MSD 时,减掉 non-mobile framework drift 是合理的;算真正 collective charge displacement 时,不能随便减掉 Li 自己的集体质心运动,否则可能把真正的集体输运信号一起删掉。
有限尺寸效应也值得提一句。对于液体,可以通过不同盒子尺寸外推
RDF 是和 MSD 并行的另一条线,回答的是不同的问题:MSD 关注 Li 最终走了多远,RDF 关注某类原子周围另一类原子在不同距离出现的概率如何。例如 Li–S RDF:
1 | mlipx analyze RUN rdf \ |
其中 --cn-cutoff 不应该机械写死:合理的配位数截断通常应该结合 RDF 第一配位峰之后的第一个谷值来选,并检查不同条件下这个定义是否仍然合理。RDF 属于结构/局域环境分析,可以和 Li site、jump、pathway 等机制分析放在后面单独展开,不要和"怎么算
¶路线图
经过前面这一大圈,我现在更愿意把整个流程压缩成一条主线:
1 | ML-MD trajectory |
这里最重要的是顺序:**先把一个温度、一个模型下的
一口气画了 Arrhenius、电导率、Haven ratio、VACF 一堆图,但连基础的 MSD 拟合区和采样误差都还没搞清楚。
学到这里,公式其实可以暂时忘掉一半,值得留下的是这些判断:
- MSD 不是越长越好用。短时间有 ballistic/caging,极长 lag 又缺 time origins,真正用于扩散系数的是中间稳定的长时间线性区。
-
-
- OLS 没有"错"。它适合快速估计斜率和做窗口敏感性,问题在于不能直接把普通 OLS 的 textbook error bar 当成 MSD 扩散系数的可靠不确定度。
- kinisi 不是另一套物理理论。它仍然建立在 Einstein/MSD 的长时间线性关系上,只是更认真地处理协方差并给出
- 单条轨迹内部的不确定度不等于整个项目的不确定度,independent replicas 仍然是检验 run-to-run reproducibility 的重要工具。
- thermostat 是否"采样正确"和是否"对动力学足够温和"是两个问题,做 transport 时必须对这个区别敏感。
- 示踪扩散和真正电荷扩散不是同一个物理量。Nernst–Einstein 是很重要的近似,但 LGPS 这类快离子导体中不能默认相关项一定可以忽略。
这部分笔记背后有几篇真正有用的文章,把它们放回各自的位置,说清楚每篇解决了什么问题。
Maginn et al., Living J. Comp. Mol. Sci. 2019, 1, 6324 是"输运性质怎么做"的总纲:Einstein 和 Green–Kubo 是什么,为什么自扩散优先用 MSD,multiple time origins,怎么选拟合区,为什么不能只看一条曲线,以及 trajectory length、replicas、finite-size、uncertainty 等需要检查什么。
Basconi & Shirts, JCTC 2013 回答的是 thermostat 对动力学到底会不会产生系统影响。它研究的是液体体系,不是 LGPS,更适合拿来理解原则,而不是直接搬数值结论。
Pranami & Lamm, JCTC 2015, 11, 4586–4592 主要回答为什么单条 MD 加 MSD 直线拟合很难给出真正可靠的统计误差。它让我意识到 trajectory length、独立模拟和相关性问题不是锦上添花,而是扩散系数可信度的一部分。
Grossfield et al., Living J. Comp. Mol. Sci. 2019 是更通用的 sampling / uncertainty quantification 指南:什么叫平衡,什么叫采样充分,有效独立样本数,自相关,block averaging,bootstrap,independent replicas,以及为什么"没看到问题"不等于"已经证明收敛"。其中大量生物分子例子不需要机械照搬到 LGPS,但统计思路非常值得借鉴。
McCluskey et al., JCTC 2025, 21, 79–87 是目前和 kinisi 最直接相关的方法论文。它回答的问题是:MSD 的不同 lag 既相关又异方差,普通 OLS 无法可靠估计斜率的不确定度,那么能不能只用一条轨迹,更高效地估计
暂时停在这里。DP-GEN 那条线,等有更大的显存再接着跑;这些笔记也先到这里,不再无限扩展。目前已经形成一条足够清楚的主线:
再往后的 collective conductivity、Haven ratio、Green–Kubo、replicas、size convergence、Arrhenius 等,都应该在这条主线真正稳定以后逐步展开。至少到这里,再看到 MSD、OLS、kinisi、lag time、credible interval 这些词时,它们不应该再是五个互不相干的新概念,而是同一条分析链上的不同环节。